

Gemini 4 Carbon, l'essentiel en quatre phrases
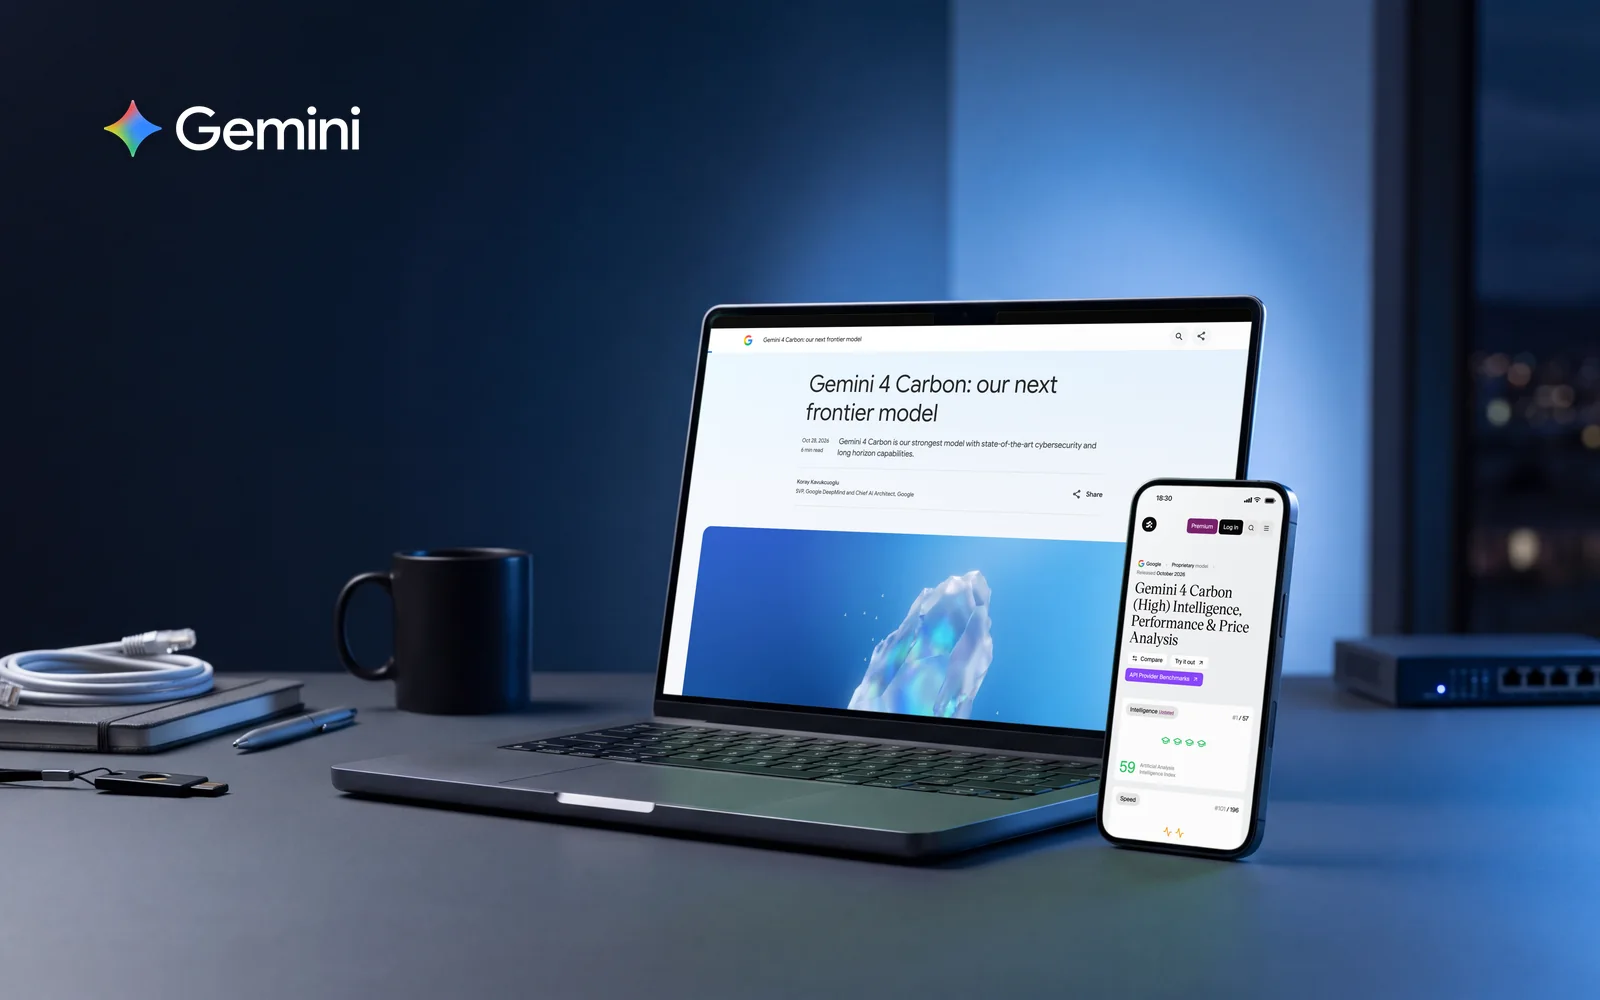
Le mardi 28 octobre 2026, Google a présenté Gemini 4 Carbon, deux semaines après l'ouverture de Gemini 4 Argon, comme son modèle le plus fort en cybersécurité et en tâches longues. Il prend la première place de l'indice indépendant d'Artificial Analysis avec 59 points, devant Claude Opus 5.5 (58) et GPT-6 Astra (57). Personne en Suisse ne peut l'utiliser aujourd'hui : Google le réserve aux défenseurs en cybersécurité de son programme Fairwind, sans date d'ouverture. Pour une PME, c'est un modèle à surveiller et à préparer, pas à attendre.
Nous avions consacré un article complet à Gemini 4 Argon le 21 octobre. Carbon reprend le même calendrier en deux temps, avec des scores plus hauts et une documentation plus mince.
Ce que Google a annoncé le 28 octobre
L'annonce est signée Koray Kavukcuoglu, vice-président de Google DeepMind. Elle tient en trois messages : le meilleur modèle de Google, l'état de l'art en cybersécurité, et une capacité à travailler plusieurs jours sur une même tâche. Google écrit que Carbon a tourné en interne pendant des jours sur de longues tâches d'ingénierie, comme trouver la cause d'un bug dans une grande base de code et le corriger.
Côté sécurité du modèle, Google avance plusieurs progrès par rapport à Argon, mesurés en interne :
- plus de deux fois plus de code sûr généré du premier coup ;
- environ deux fois moins d'affirmations sans appui ;
- 0,0 % d'attaques réussies par injection de consignes sur le test de Gray Swan, contre 0,7 % pour Argon ;
- près de 80 % d'alertes graves de comportement inattendu en moins dans les environnements de code des équipes de Google ;
- 26 % de moins d'excès de zèle, quand le modèle fait plus que ce qu'on lui demande, et 29 % de moins de travail laissé incomplet.
Ces chiffres viennent tous de Google. Ils sont plausibles, mais aucun n'a encore été vérifié de l'extérieur.
Qui peut l'utiliser, et quand
Google décrit un accès en trois étapes : une partie des défenseurs en cybersécurité dès la semaine de l'annonce, puis d'autres partenaires de confiance du programme Fairwind, puis les développeurs, les entreprises et le grand public « dès que possible ». Carbon fait aussi partie du processus volontaire de test avant publication du gouvernement américain.
La page du programme Fairwind précise qui passe en premier : les gouvernements et les autorités nationales de cybersécurité, les opérateurs d'infrastructures critiques (santé, télécoms, énergie, réseaux financiers) et les grandes plateformes technologiques. Les candidats sont vérifiés, et la demande passe par l'équipe commerciale Google Cloud du client. Google revendique plus de 650 partenaires dans le monde. Au 30 octobre, cette page ne mentionne d'ailleurs encore qu'Argon.
Le précédent d'Argon donne un ordre de grandeur : annoncé le 30 septembre, ouvert aux clients payants le 13 octobre, soit treize jours plus tard. Rien ne garantit que Carbon suivra le même rythme, et le journal des versions de l'API Gemini ne lui attribue encore aucun identifiant.
Les scores de Google, lus dans les deux sens
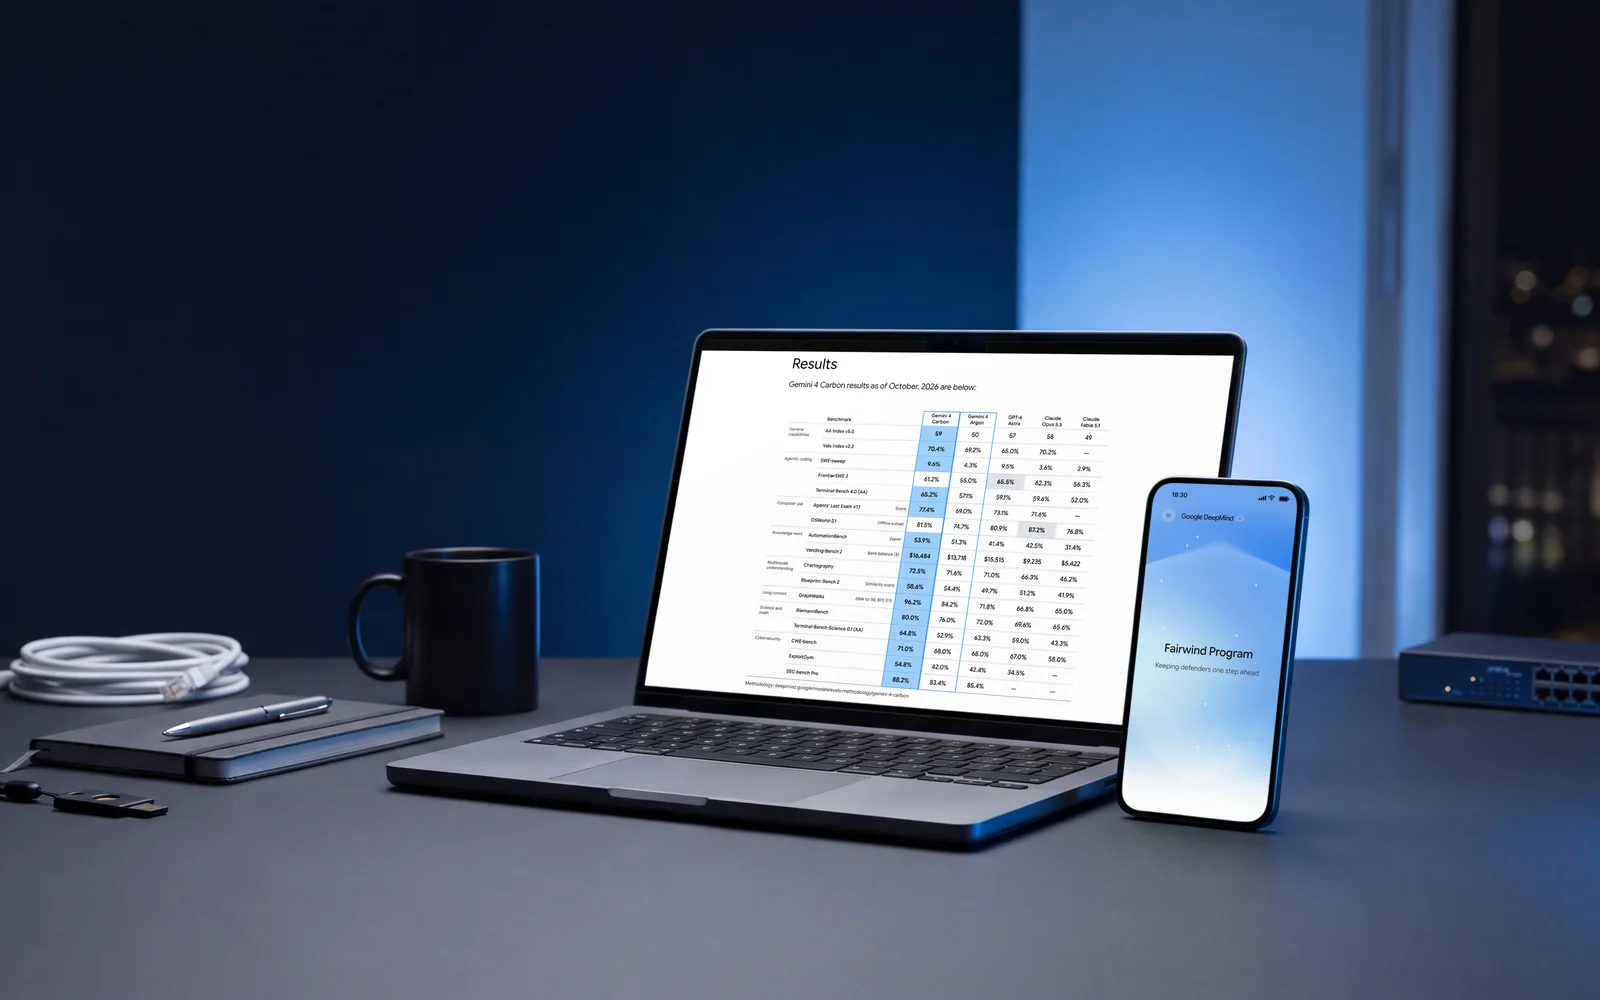
Google publie un tableau de 18 tests face à Argon, GPT-6 Astra, Claude Opus 5.5 et Claude Fable 5.1. Carbon y est en tête sur 16 lignes. Les deux exceptions sont parlantes : FrontierSWE 2, l'ingénierie logicielle, où Astra mène (65,5 % contre 61,2 %), et OSWorld 2.1, le pilotage d'un ordinateur, où Claude Opus 5.5 mène (87,2 % contre 81,5 %).
 Argon)
 Opus 5.5)Opus 5.5)
 Astra)Astra)Astra)Opus 5.5)Claude Code et Opus 5.5)
La méthode mérite trois remarques. D'abord, Google mesure Carbon au niveau de réflexion le plus élevé, et reprend pour ses concurrents les chiffres que leurs éditeurs ont publiés, parfois dans d'autres conditions. Ensuite, les scores de cybersécurité sont mesurés « sans protections », selon les termes de Google : c'est la version que reçoivent les défenseurs de Fairwind, pas celle que le public recevra. Enfin, sur un test comme ExploitGym, chaque tâche peut durer jusqu'à six heures, ce qui dit beaucoup sur le type de travail visé.
Ce que disent les mesures indépendantes
Artificial Analysis fait tourner les modèles lui-même. Sur son indice v5, Carbon obtient 59 points, Claude Opus 5.5 58, GPT-6 Astra 57 et Argon 50. Attention à la comparaison avec notre article d'octobre : Argon y avait 53 points sur la version précédente de l'indice, et les deux échelles ne se comparent pas.
Deux points d'écart entre les trois premiers, c'est l'épaisseur d'une erreur de mesure. Artificial Analysis le dit lui-même : Carbon progresse beaucoup en code et en travail de bureau, mais n'est pas en tête dans ces domaines. Sur son indice des agents de code, Claude Code avec Opus 5.5 garde trois points d'avance.
Le résultat le plus utile pour une PME est ailleurs. Sur le test AA-Omniscience v1.1, Carbon répond juste à 58 % des questions et invente une réponse dans 11 % des cas, contre 50 % pour Claude Opus 5.5 et pour GPT-6 Astra. Argon reste plus prudent, à 4 %, mais répond juste moins souvent. Pour une fiduciaire ou un service juridique, cette tendance de la famille Gemini à dire « je ne sais pas » plutôt qu'à inventer pèse plus que n'importe quel classement.
Le coût par tâche, pas le prix par token
Google annonce pour Carbon le même tarif qu'Argon : 2 USD par million de tokens en entrée et 10 USD en sortie pendant le lancement, puis 4 et 20 USD. Selon Artificial Analysis, cette remise de lancement n'a pas de date de fin confirmée pour Carbon. Le vrai chiffre est ailleurs : ce que coûte une tâche complète, réflexion comprise.
Claude Opus 5.510,04Gemini 4 Carbon7,76Gemini 4 Argon7,68GPT-6 Astra6,25Carbon reste bavard : 123'000 tokens de sortie en moyenne par tâche, soit 29 % de moins que Claude Opus 5.5, mais assez pour que le prix par token ne dise pas grand-chose. GPT-6 Astra, quatre fois plus cher par token en sortie, revient moins cher par tâche parce qu'il écrit beaucoup moins. La lenteur suit la même logique : Artificial Analysis mesure en moyenne 103 secondes avant le premier mot de Carbon par l'API de Google, contre 49 secondes pour Argon. Pour un chatbot de service client, ce délai compte autant que la qualité.
Ce qu'en dit X
Le post d'Artificial Analysis annonçant Carbon premier de son indice a été vu plus de 600'000 fois, celui de Google environ 180'000. Le ton des réactions tient en une phrase d'un utilisateur, @UhrsNix, qui résume le lancement ainsi : dix sur dix aux tests, zéro sur dix en disponibilité (post du 29 octobre). Un autre, @BuildToCite, salue le premier rang et le prix de lancement, tout en relevant des premières évaluations jugées « très verbeuses » et l'absence de calendrier pour AI Studio et Vertex (post du 29 octobre). Ce sont de petits comptes, mais la verbosité qu'ils signalent se retrouve dans les mesures d'Artificial Analysis.
Ce qui manque dans la documentation
Pour Argon, Google avait publié une fiche technique et un rapport de sécurité détaillé. Pour Carbon, au 30 octobre, nous n'avons trouvé que l'annonce et un document d'évaluation de cinq pages. La page de fiche technique attendue pour Carbon n'existe pas, et le rapport de sécurité vers lequel renvoie l'annonce est celui d'Argon : il ne cite jamais Carbon. Fenêtre de contexte, formats acceptés, région de traitement : ces informations viennent pour l'instant d'Artificial Analysis (un million de tokens ; texte, image, vidéo et voix en entrée, texte en sortie), pas de Google.
Pour un modèle présenté comme le plus fort de Google en cybersécurité, cette discrétion surprend. Elle n'est pas forcément inquiétante, puisque le modèle reste fermé, mais aucune entreprise ne devrait l'adopter avant de lire une fiche technique complète.
Données et nLPD : ce qui vaut dès aujourd'hui
Carbon n'est pas encore là, mais une nouveauté de l'API Gemini concerne déjà les PME qui utilisent Argon ou Gemini 3.8 Flash. Depuis le 26 octobre 2026, selon le journal des versions de Google, les nouveaux projets payants de l'API stockent par défaut les requêtes envoyées par l'API Generate Content. Les projets existants gardent leur réglage. On peut le couper requête par requête (`store=false`) ou dans les réglages de journalisation du tableau de bord. Si vous créez un projet pour un client, vérifiez ce réglage avant d'envoyer des données personnelles.
Pour le reste, le cadre d'Argon reste la meilleure indication : traitement possible dans la zone Union européenne, compatible avec la nLPD pour la plupart des PME, mais pas de traitement en Suisse annoncé. Notre guide protection des données et IA sous la nLPD détaille ce qu'il faut vérifier.
Ce qu'une PME romande peut faire maintenant
- 1Ne demandez pas l'accès à Fairwind si vous n'êtes ni une autorité, ni un opérateur d'infrastructure critique, ni une grande plateforme : la demande passe par Google Cloud et vise d'autres profils.
- 2Préparez votre banc d'essai : 10 à 20 tâches réelles dont vous connaissez la bonne réponse, anonymisées, avec vos critères fixés à l'avance. Testez-le dès maintenant sur Argon, Claude et ChatGPT ; le jour où Carbon ouvre, il suffit de le relancer.
- 3Mesurez le coût et le délai par tâche, pas par token. Les écarts de coût et de délai vus plus haut se retrouvent sur vos propres dossiers.
- 4Appliquez vos mises à jour de sécurité sans attendre. Des modèles qui trouvent et exploitent des failles en quelques heures existent, chez Google comme chez Anthropic avec Claude Mythos. Les failles connues de vos logiciels se trouvent désormais plus vite.
- 5Protégez vos agents contre l'injection de consignes : un agent qui lit vos emails ou des pages web peut recevoir des ordres cachés. Le 0,0 % annoncé par Google est un progrès pour Carbon, pas une garantie pour vos outils actuels. C'est un point que nous traitons dans chaque projet d'agents IA.
Notre position
Carbon confirme que Google a rejoint le groupe de tête, et que l'écart entre les trois premiers se compte désormais en points. Pour une PME romande, la conséquence est simple : aucun modèle ne justifie de tout migrer, et celui qui teste vite sur ses propres tâches garde l'avantage sur celui qui suit les classements. Claude reste notre premier choix pour l'analyse, la rédaction et le développement ; nous referons le test le jour où Carbon ouvrira, sur les mêmes tâches.
La méthode que nous enseignons ne dépend pas du modèle : structurer une demande, fournir le bon contexte, vérifier le résultat. C'est le cœur de notre formation IA en entreprise, et un banc d'essai sur vos dossiers se construit en une demi-journée avec nous.
Questions fréquentes
Peut-on utiliser Gemini 4 Carbon en Suisse ?
Pas encore. Depuis le 28 octobre 2026, Google ne l'ouvre qu'à une partie des défenseurs en cybersécurité, puis à d'autres partenaires de son programme Fairwind. Il n'est ni dans l'application Gemini, ni dans l'API publique, et Google promet une ouverture aux développeurs, aux entreprises et au grand public « dès que possible », sans date.
Combien coûtera Gemini 4 Carbon ?
Google annonce le même tarif qu'Argon : 2 USD par million de tokens en entrée et 10 USD en sortie pendant le lancement, puis 4 et 20 USD. Mesuré par Artificial Analysis au tarif standard, Carbon coûte 7,76 USD par tâche de son indice, autant qu'Argon, environ 23 % de moins que Claude Opus 5.5 et environ 1,2 fois GPT-6 Astra.
Gemini 4 Carbon est-il meilleur que Claude et ChatGPT Astra ?
Sur l'indice indépendant d'Artificial Analysis, il est premier avec 59 points, contre 58 pour Claude Opus 5.5 et 57 pour GPT-6 Astra : un écart de deux points entre les trois. Il reste derrière Claude Opus 5.5 sur les agents de code et derrière plusieurs modèles sur les tâches de bureau évaluées par Artificial Analysis.
Qu'est-ce que le programme Fairwind ?
C'est le programme d'accès anticipé de Google pour la cyberdéfense. Il donne la priorité aux gouvernements, aux opérateurs d'infrastructures critiques et aux grandes plateformes, avec vérification des candidats. La demande passe par l'équipe commerciale Google Cloud du client. Une PME ordinaire n'en fait pas partie.
Gemini 4 Carbon invente-t-il moins de réponses ?
Selon Artificial Analysis, Carbon invente une réponse dans 11 % des cas sur son test AA-Omniscience v1.1, contre 50 % pour Claude Opus 5.5 et GPT-6 Astra. C'est plus qu'Argon, à 4 %, mais Carbon répond juste plus souvent, 58 % des questions.
Faut-il attendre Carbon avant de choisir un outil d'IA ?
Non. Carbon n'a pas de date d'ouverture, et les trois premiers modèles se tiennent en deux points. Une PME a plus à gagner à construire dès maintenant un banc d'essai sur ses propres tâches, qui servira à tester Carbon le jour où il ouvrira.
Sources
Sources consultées le 30 octobre 2026. Les scores publiés par Google n'ont pas été répliqués de façon indépendante à cette date, sauf ceux mesurés par Artificial Analysis. Les écrans des images sont de vraies captures de blog.google, de deepmind.google, d'artificialanalysis.ai et du document d'évaluation de Google, mises en scène par DKDP ; les logos Gemini, Google, Claude, ChatGPT et OpenAI appartiennent à leurs éditeurs.
- Google, « Gemini 4 Carbon: our next frontier model », 28 octobre 2026
- Google DeepMind, document d'évaluation de Gemini 4 Carbon (PDF)
- Google DeepMind, rapport de sécurité de Gemini 4 Argon (PDF), cité par l'annonce de Carbon
- Google DeepMind, programme Fairwind
- Google AI for Developers, journal des versions de l'API Gemini
- Artificial Analysis, fiche de Gemini 4 Carbon
- Artificial Analysis sur X, analyse de Carbon, 28 octobre 2026
- Google sur X, 28 octobre 2026
- @UhrsNix sur X, 29 octobre 2026
- @BuildToCite sur X, 29 octobre 2026
Nos services
Vous avez des questions ? On peut vous aider.
Formez vos collaborateurs aux outils IA adaptés à leur métier.
Decouvrir →Audit & Conseil IAIdentifiez vos opportunités IA concrètes en 1 session.
Decouvrir →Automatisation IAWorkflows automatisés qui libèrent vos équipes des tâches répétitives.
Decouvrir →Formation Claude IAClaude.ai, Projects et Claude Code pour vos équipes, du débutant à l'avancé.
Decouvrir →