

Opus 5.5 plus bête, l'essentiel en quatre phrases
Le samedi 24 octobre 2026, un ancien membre de l'équipe Claude Code d'Anthropic, le jour de son départ, a demandé sur X si c'était lui ou si Claude Opus 5.5 était devenu plus bête. Le message a dépassé 970'000 vues et ouvert les vannes : captures comparées, tickets sur GitHub, accusations de « nerf », ce mot des joueurs de jeux vidéo pour une arme qu'on affaiblit en douce. Au 2 novembre, aucun test indépendant ne mesure de baisse, Anthropic n'a rien dit, et quelques utilisateurs très outillés présentent des chiffres troublants. Pour une entreprise qui travaille avec Claude chaque jour, la vraie question n'est pas « qui a raison » mais « comment je le saurais pour mes propres tâches ».
Ce qui s'est passé depuis la sortie d'Opus 5.5
Anthropic a lancé Claude Opus 5.5 le 22 septembre 2026, moins cher qu'Opus 5 et meilleur sur les tâches longues. Les premières plaintes sont arrivées une semaine plus tard, puis la vague a enflé fin octobre.
- 5 octobre : un ticket sur le dépôt public de Claude Code affirme que la qualité est « redescendue au niveau d'Opus 5 ». Un participant y montre que le nombre de mots de réflexion par réponse est passé de 196 à 63 après une mise à jour de l'outil, et que revenir à la version précédente a rétabli la qualité. Une mesure d'un seul utilisateur, non confirmée par d'autres.
- 24 octobre : le message viral sur X, publié en réponse à un message d'adieu de ses collègues. Beaucoup y lisent une pique de départ autant qu'un diagnostic, mais il donne un visage à des semaines de ressenti.
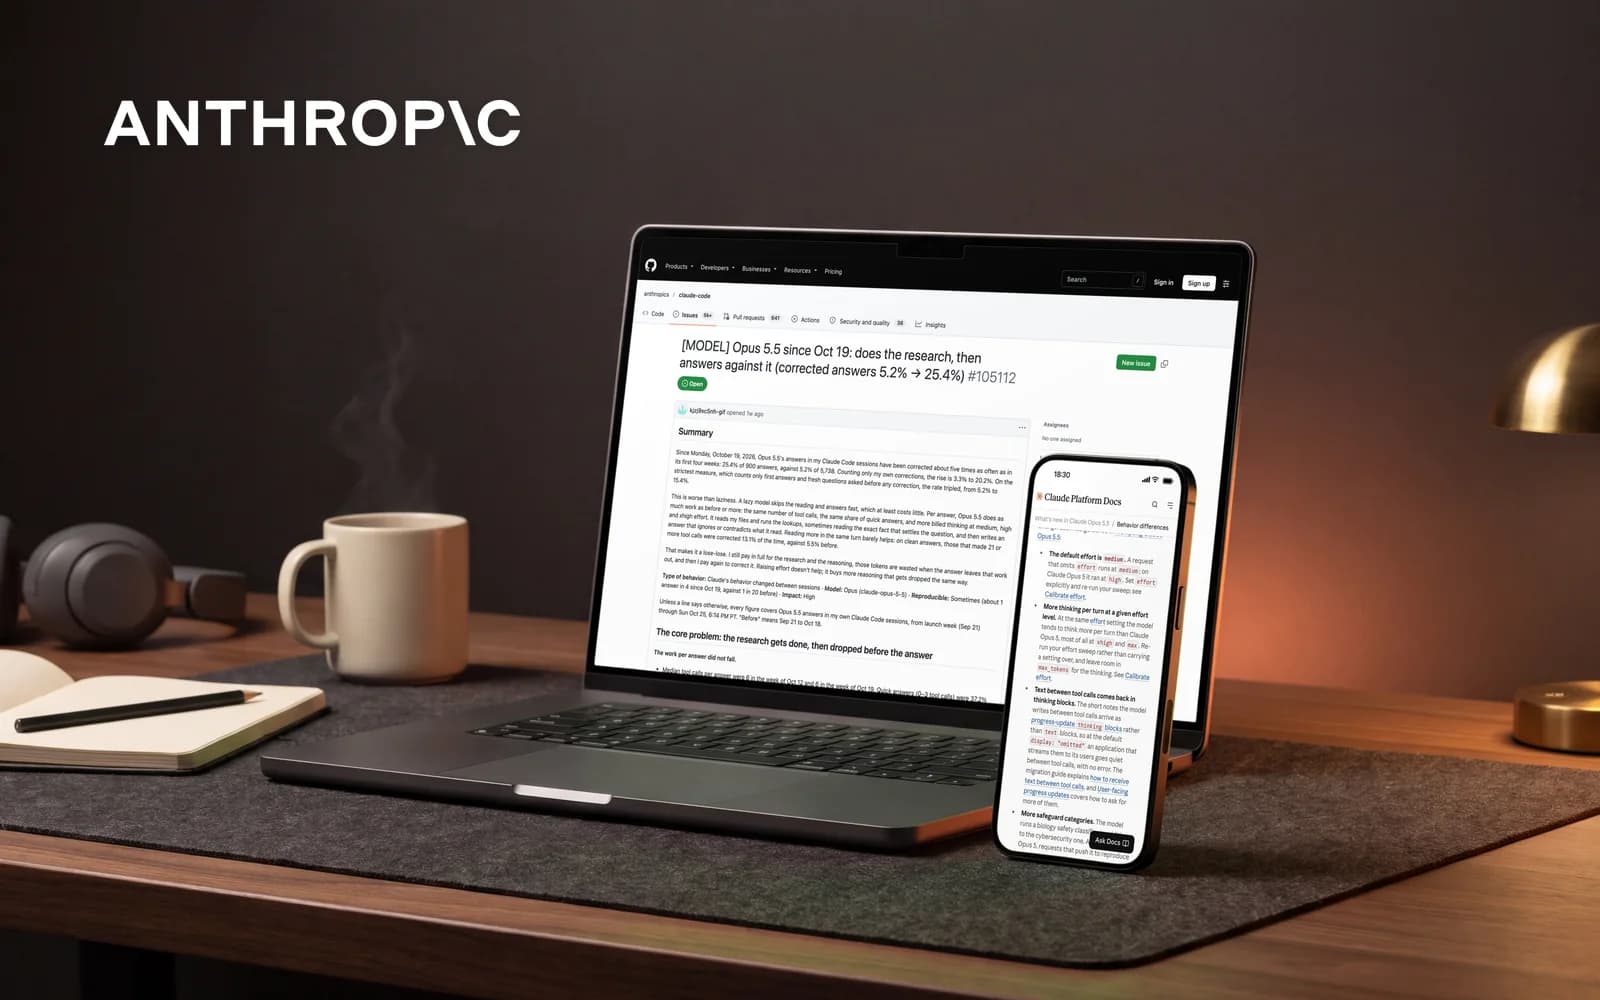
- 26 octobre : un nouveau ticket GitHub, très détaillé, affirme que depuis le 19 octobre, 25,4 % de ses réponses d'Opus 5.5 ont dû être corrigées, contre 5,2 % pendant les quatre premières semaines, sur plus de 6'600 réponses mesurées par script. Selon son auteur, le modèle fait bien ses recherches puis répond à l'inverse de ce qu'il vient de lire.
Aucun de ces tickets n'a reçu de réponse d'Anthropic au moment où nous écrivons.
Ce qui est confirmé, ce qui ne l'est pas
Confirmé : la documentation officielle d'Anthropic indique que le réglage d'effort par défaut d'Opus 5.5 est « medium », alors qu'Opus 5 tournait en « high ». Une demande qui ne précise rien réfléchit donc moins qu'avec l'ancien modèle. Anthropic recommande lui-même de régler l'effort explicitement et de refaire ses tests.
Confirmé : Anthropic a déjà dégradé la qualité de Claude sans le vouloir, deux fois, et l'a reconnu par écrit. En septembre 2025, trois bugs de serveurs avaient touché jusqu'à 16 % des requêtes de Sonnet 4 pendant l'heure la plus touchée. En avril 2026, trois changements dans Claude Code (effort par défaut abaissé, un bug de mémoire de session, une consigne pour raccourcir les réponses) avaient dégradé les réponses pendant plusieurs semaines. Dans les deux cas, le modèle lui-même n'avait pas changé.
Mesuré, sans baisse : LiveNerf, un test public de 78 questions relancé chaque jour sur Opus 5.5 depuis le 24 septembre, ne voit aucune chute. Sa dernière lecture, au 31 octobre, donne 64,1 % de bonnes réponses, contre 58,4 % de moyenne la semaine du lancement. Le suivi NerfBench de BridgeBench oscille entre 94,2 % et 105,8 % du niveau de lancement, sans tendance nette.
Non confirmé : l'idée qu'Anthropic ferait tourner une version allégée du modèle aux heures de pointe, ou qu'il le remplacerait en douce par un modèle plus petit. Aucune preuve publique ne l'étaye, et Anthropic l'a démenti par écrit en 2025 et en 2026, sans s'exprimer sur Opus 5.5.
Non expliqué : les mesures précises de certains utilisateurs avancés, comme le ticket du 26 octobre. Elles portent sur une seule personne et une seule façon de travailler, mais elles sont trop détaillées pour être balayées d'un revers de main.
Le phénomène : quatre couches entre vous et le modèle
Quand on dit « Claude est devenu plus bête », on parle rarement du modèle seul. Entre la question tapée et la réponse, quatre couches peuvent bouger, et seule la première est censée rester figée.

S'y ajoute un effet bien connu : la lune de miel. Les premiers jours, on teste le nouveau modèle sur ce qu'il fait le mieux et on s'émerveille. Trois semaines plus tard, on lui confie le travail courant, avec ses cas tordus, et on retient ses ratés. Un studio qui a relancé dix fois le même travail dans Claude Code, le 21 octobre, a obtenu des notes allant de 4 à 8 sur 10 pour une seule et même demande. La réponse « d'hier » qui semblait meilleure se situait en réalité au milieu du lot.
Reste le point le plus intéressant pour nos clients : les deux épisodes reconnus par Anthropic venaient des couches 2 et 3, invisibles pour l'utilisateur, et ses propres tests ne les avaient pas détectés. Dans son rapport de 2025, Anthropic écrit lui-même que ses évaluations n'avaient pas capté la baisse que les utilisateurs signalaient. Le ressenti des utilisateurs n'est donc pas de la paranoïa : c'est parfois le premier signal. Il ne devient une preuve que mesuré.
Ce que ça change pour une PME romande
Pour une entreprise qui utilise Claude dans le chat, la conséquence est simple : si les réponses vous semblent moins bonnes, la cause la plus probable est votre session ou votre demande, et la seconde est un réglage de l'outil. Ouvrir une conversation neuve, redonner le contexte essentiel et préciser ce qu'on attend règle la majorité des cas. Notre article sur la gestion de la fenêtre de contexte dans Claude détaille pourquoi une longue conversation finit par dégrader les réponses.
Pour une équipe qui a branché Claude dans ses processus, par Claude Code, un agent ou l'API, l'enjeu est plus sérieux. Un changement de comportement non annoncé peut casser un traitement qui marchait la veille, sans message d'erreur. C'est exactement ce que décrit le ticket du 26 octobre : le travail continue, mais il faut tout reprendre derrière. Nous l'avions déjà relevé en lisant le prospectus d'entrée en bourse d'Anthropic, qui réserve à l'éditeur le droit de modifier les capacités de ses produits.
Le test d'une heure à mettre en place cette semaine
- 1Réglez l'effort vous-même. Dans Claude Code, vérifiez le niveau d'effort et le modèle actif avant de juger une réponse ; dans l'API, indiquez toujours le paramètre d'effort plutôt que de dépendre du réglage par défaut.
- 2Choisissez cinq à dix demandes de votre métier : une offre à rédiger, un tableau à analyser, un courriel délicat, un script à corriger. Gardez la meilleure réponse obtenue comme référence.
- 3Relancez-les une fois par mois, trois fois chacune, dans une conversation neuve et avec le même réglage. Notez sur 10, sans regarder la date.
- 4Documentez vos consignes dans un fichier de travail, pour que la méthode survive à un changement de modèle. Notre guide sur la configuration de Claude Code et du fichier CLAUDE.md montre comment.
- 5Gardez une solution de repli essayée, un second modèle testé sur deux ou trois tâches clés, pour ne pas dépendre d'un seul fournisseur un jour de panne ou de doute.
Notre position
Au 2 novembre 2026, rien ne prouve qu'Opus 5.5 soit devenu plus bête, et nous continuons à le recommander pour l'analyse, la rédaction et le développement. Mais nous ne balayons pas non plus les plaintes : Anthropic a déjà cassé la qualité de Claude deux fois sans le vouloir, et il a fallu des semaines de signalements d'utilisateurs pour qu'il le reconnaisse. Son silence actuel sur Opus 5.5 n'aide pas.
La leçon dépasse Claude. Un outil d'IA loué en ligne change sans prévenir, en bien comme en mal, et la seule défense est de mesurer ses propres usages. C'est ce que nous apprenons aux équipes dans notre formation Claude pour les entreprises : bien régler l'outil, construire ses demandes de référence, vérifier ce qui sort. Et si vous avez branché Claude dans vos processus, notre accompagnement IA aide à mettre en place ces tests et une solution de repli.
Questions fréquentes
Claude Opus 5.5 est-il vraiment devenu moins bon ?
Rien ne le prouve au 2 novembre 2026. Les deux suivis quotidiens indépendants qui testent Opus 5.5 sur des questions fixes ne mesurent aucune baisse au-delà du bruit, et le plus récent le place même un peu au-dessus de sa semaine de lancement. Des utilisateurs avancés documentent en revanche des baisses précises dans leurs propres sessions de Claude Code, que personne n'a encore expliquées.
Anthropic dégrade-t-il ses modèles pour économiser de la puissance de calcul ?
Anthropic affirme que non, par écrit, en septembre 2025 comme en avril 2026. Il a en revanche reconnu deux fois que des bugs de serveurs ou des changements de réglages dans Claude Code avaient dégradé les réponses pendant plusieurs semaines, sans que le modèle lui-même change. Au 2 novembre 2026, il n'a fait aucune déclaration sur Opus 5.5.
Pourquoi Claude semble-t-il moins bon après quelques semaines ?
Plusieurs causes se cumulent : le réglage d'effort, que Claude Code règle sur medium par défaut avec Opus 5.5, les changements de l'outil autour du modèle, les longues sessions qui saturent le contexte, et la variabilité naturelle des réponses. Un même test relancé dix fois peut obtenir des notes allant de 4 à 8 sur 10.
Comment vérifier si Claude répond moins bien dans mon entreprise ?
Gardez cinq à dix demandes typiques de votre métier avec une bonne réponse de référence, relancez-les chaque mois dans les mêmes conditions, trois fois chacune, et notez le résultat. Sans cette base, il est impossible de distinguer une vraie baisse d'une mauvaise journée.
Faut-il quitter Claude pour un autre outil ?
Non, pas sur la base de ces plaintes. Les mêmes soupçons visent régulièrement ChatGPT et Gemini. La bonne réponse est de régler l'effort explicitement, de tester ses tâches clés et de garder une solution de repli essayée sur deux ou trois cas.
Sources
Sources consultées le 2 novembre 2026. Les chiffres des tickets GitHub sont ceux de leurs auteurs et n'ont pas été vérifiés de façon indépendante. Les écrans des images sont de vraies captures de github.com, platform.claude.com et anthropic.com, mises en scène par DKDP ; le logo Anthropic appartient à son éditeur.
- Anthropic, « What's new in Claude Opus 5.5 », documentation officielle (effort par défaut sur medium)
- Anthropic, « An update on recent Claude Code quality reports », 23 avril 2026
- Anthropic, « A postmortem of three recent issues », 17 septembre 2025
- GitHub, anthropics/claude-code, ticket 105112, ouvert le 26 octobre 2026
- GitHub, anthropics/claude-code, ticket 99572, ouvert le 5 octobre 2026
- LiveNerf, suivi quotidien d'Opus 5.5 sur 78 questions
- BridgeBench, NerfBench
- Jamin Labs, « Did Opus 5.5 get nerfed? », 21 octobre 2026
- CellCog, « Is Claude Opus 5.5 nerfed? What the trackers measured », 25 octobre 2026
- Le message viral sur X, 24 octobre 2026
Nos services
Vous avez des questions ? On peut vous aider.
Claude.ai, Projects et Claude Code pour vos équipes, du débutant à l'avancé.
Decouvrir →Formation IA entrepriseFormez vos collaborateurs aux outils IA adaptés à leur métier.
Decouvrir →Audit & Conseil IAIdentifiez vos opportunités IA concrètes en 1 session.
Decouvrir →Automatisation IAWorkflows automatisés qui libèrent vos équipes des tâches répétitives.
Decouvrir →